Integração de IA à documentação interna e os impactos de uma documentação desorganizada
Um dos maiores desafios ao iniciar um novo projeto ou ingressar em uma nova empresa é o processo de aprendizagem e adaptação. A necessidade de entender constantemente o que precisa ser feito e como executar cada tarefa pode comprometer a agilidade, especialmente quando processos internos, regras de negócio e requisitos técnicos se cruzam.
Durante minha experiência com a sustentação de sistemas legados em Delphi e PHP, comecei a perceber como uma boa documentação é fundamental para trabalhar com mais autonomia e confiança no dia a dia. Buscando maneiras de manter essas informações sempre acessíveis, deparei-me com situações em que, mesmo estando hospedada em plataformas de terceiros, como o Confluence, a documentação ficava temporariamente indisponível ou apresentava alta latência.
Inicialmente, comecei a manter cópias locais dos documentos utilizando ferramentas do pacote Office. Entretanto, percebi que estava gastando cada vez mais tempo acessando diretórios pelo PowerShell, copiando arquivos e consultando máquinas virtuais.
Foi então que decidi aproveitar os conhecimentos adquiridos no CS50, curso de Harvard que eu estava realizando na época e que abordava a linguagem C, para desenvolver uma ferramenta de linha de comando (CLI). A ideia era converter a documentação para arquivos TXT e criar um mecanismo de busca baseado em palavras-chave, capaz de retornar trechos relevantes a partir das consultas realizadas.
Para pesquisas rápidas e pontuais, a ferramenta se mostrou bastante útil. No entanto, com o tempo, especialmente ao começar a trabalhar com um grande volume de clientes simultaneamente e informações em diferentes idiomas, percebi que a documentação havia deixado de ser apenas uma fonte de consulta: ela era parte essencial da execução dos processos.
Organização da documentação
Recentemente, um dos meus maiores desafios deixou de ser o acesso à documentação e passou a ser sua organização. É um equívoco acreditar que ter todas as informações documentadas é suficiente para resolver os problemas de consulta. A forma como esses dados são estruturados e relacionados também faz toda a diferença.
Um dos problemas que enfrentei foi encontrar informações importantes distribuídas entre diversos arquivos. Ao localizar os dados de acesso a uma máquina virtual em uma planilha, por exemplo, era comum precisar consultar outro documento para encontrar informações sobre o banco de dados ou a organização interna do ambiente.
À primeira vista, isso pode parecer apenas um pequeno inconveniente. Entretanto, imagine essa situação durante a tratativa de jobs críticos no Control-M de uma multinacional, em que é necessário consultar diferentes informações simultaneamente, cumprir prazos curtos e manter um alto nível de atenção devido à criticidade das operações. Nesse contexto, cada etapa adicional de consulta pode comprometer a agilidade e aumentar o risco de erros.
A partir dessas experiências, decidi desenvolver uma ferramenta que reunisse a rapidez de consulta do meu programa CLI em C com uma interface gráfica acessível ao restante da equipe. Além de centralizar a documentação, o sistema deveria oferecer recursos de pesquisa mais abrangentes, capazes de encontrar informações relevantes em diferentes arquivos.
Minha primeira ideia foi desenvolver uma aplicação web convencional. Porém, eu queria facilitar a distribuição da ferramenta sem depender da disponibilidade de um servidor, de configurações de rede ou de processos burocráticos para obter acesso à infraestrutura corporativa. Também precisava evitar a necessidade de instalar dependências nos computadores da empresa, que poderiam exigir permissões administrativas.
A solução foi desenvolver uma aplicação web com Flask, executada localmente por meio de um executável .exe que utiliza o mecanismo de renderização do Chromium. Todas as dependências e os arquivos necessários são empacotados em um arquivo ZIP, permitindo distribuir o sistema de maneira simplificada.
O usuário pode importar a documentação por meio de uma interface de upload, que realiza o processamento dos arquivos dentro da própria aplicação. Depois de organizar e carregar os documentos, basta distribuir a pasta do sistema para os demais usuários, que passam a ter acesso à mesma base documental.
Além da centralização das informações, priorizei a experiência do usuário, buscando uma interface leve, intuitiva e fácil de utilizar. Dessa forma, aproveitei a flexibilidade de personalização do front-end de uma aplicação web sem abrir mão da praticidade de uma ferramenta executada localmente.
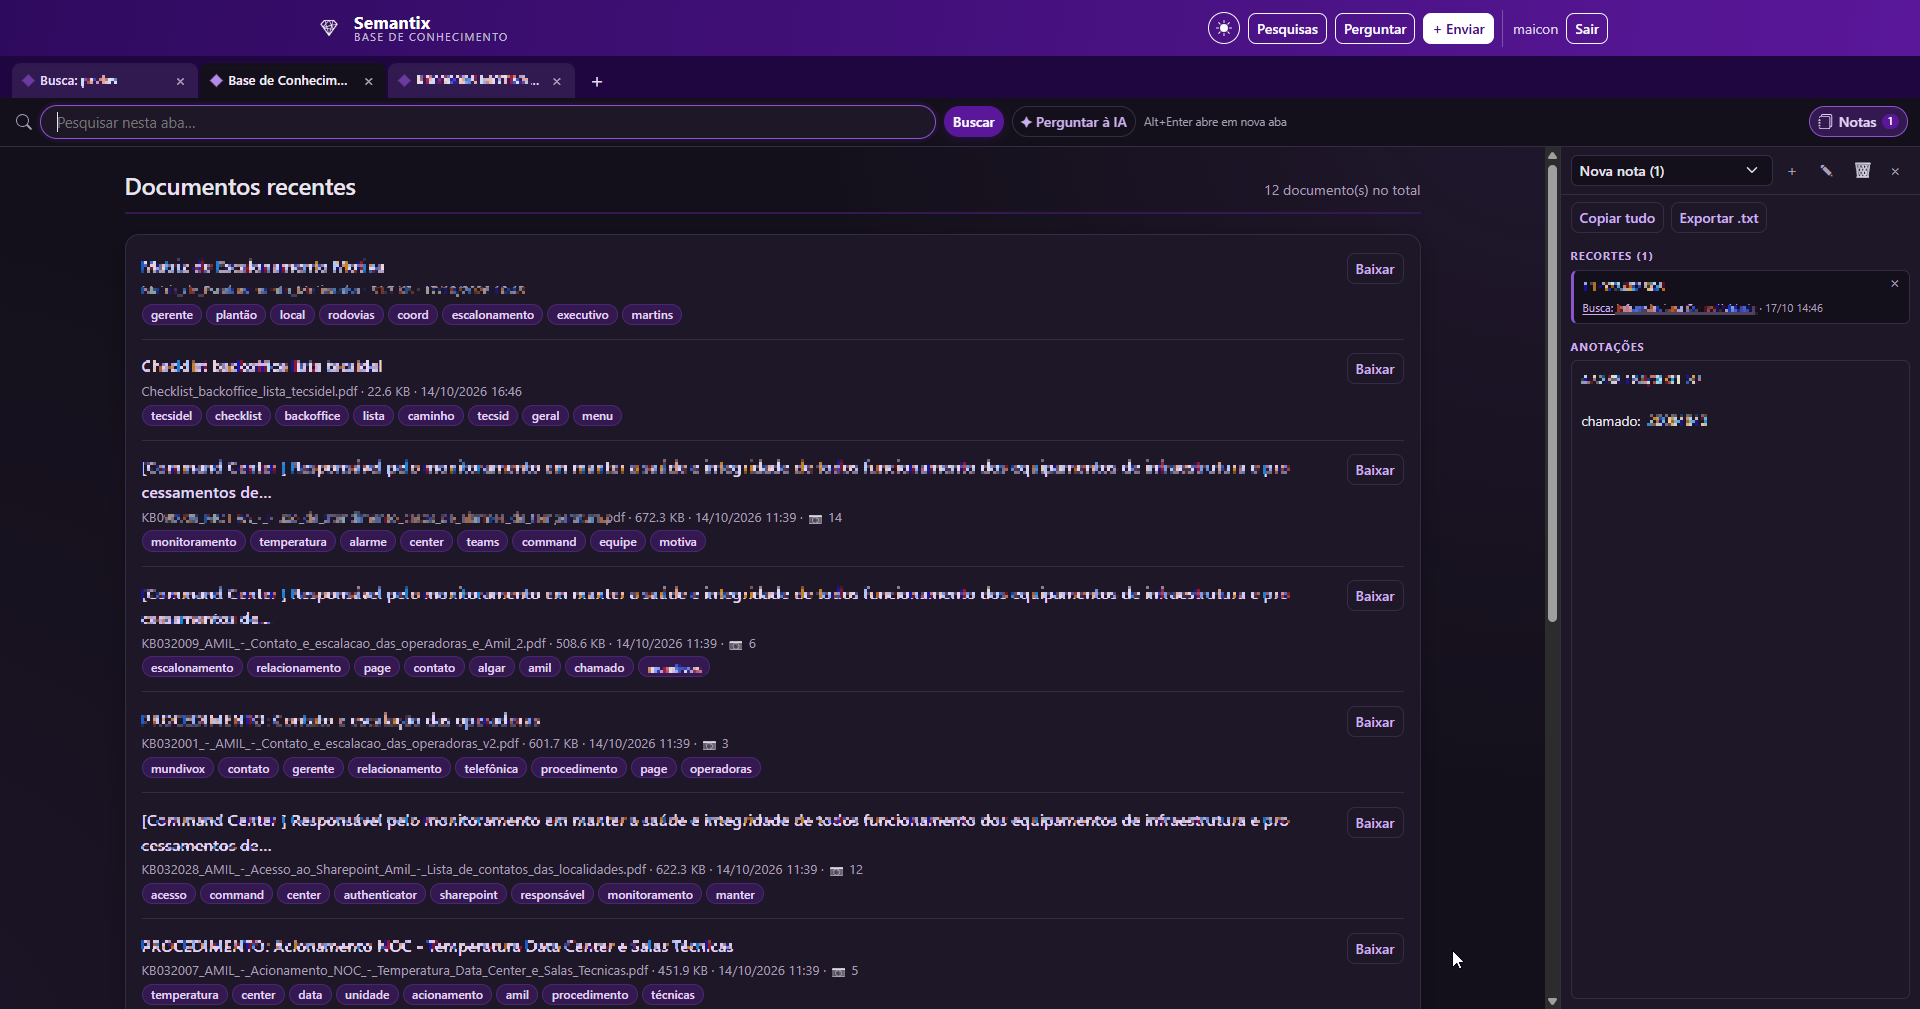
Em pouco tempo, os resultados começaram a aparecer. Antes, encontrar determinadas informações exigia consultar diversas planilhas e documentos, cruzando os dados manualmente. Com o novo sistema, essas consultas passaram a ser realizadas por meio de uma única barra de pesquisa, com relacionamentos automáticos entre as informações disponíveis na documentação.
O que antes poderia exigir a consulta de várias tabelas e arquivos passou a ser resolvido com uma pesquisa por palavras-chave, reduzindo o tempo necessário para localizar informações relevantes.
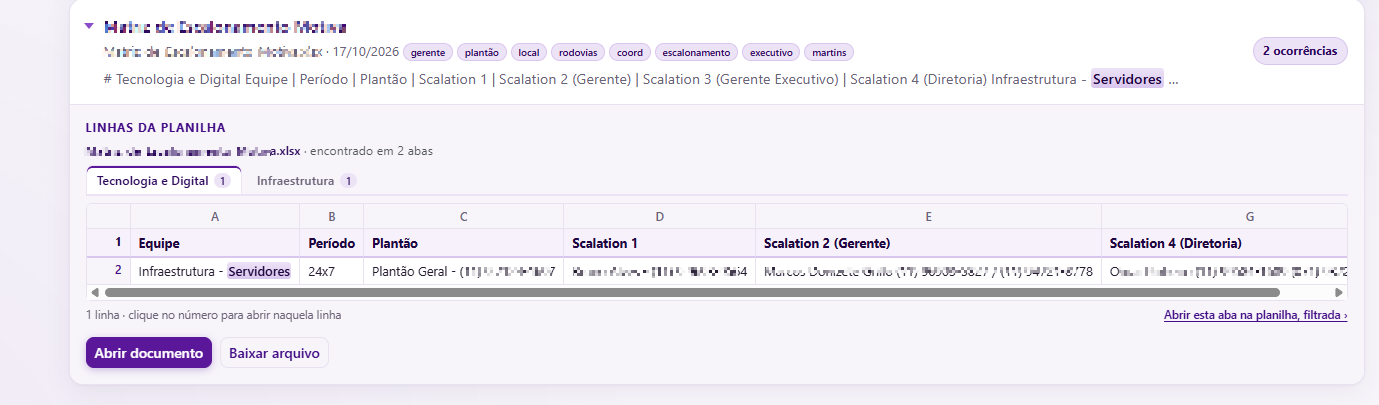
Além da pesquisa, identifiquei outra necessidade recorrente: realizar anotações rápidas durante as atividades do dia a dia. Para atender a essa demanda, implementei um bloco de notas integrado à plataforma, com suporte à inclusão de links e referências internas.
Assim, as informações encontradas durante uma pesquisa podem ser utilizadas diretamente nas anotações, facilitando a organização de dados importantes e evitando que o usuário precise alternar constantemente entre diferentes ferramentas.
IA na amplificação das buscas
Outra possibilidade que eu já vinha estudando era a integração de inteligência artificial à plataforma, com o objetivo de aprimorar as pesquisas na documentação, gerar resumos e permitir consultas mais dinâmicas.
O principal obstáculo inicial foi encontrar uma maneira de utilizar essa tecnologia sem expor informações sensíveis da empresa a serviços externos. Por esse motivo, descartei inicialmente a possibilidade de integrar as consultas a APIs de provedores como Google Gemini ou OpenAI, já que isso exigiria uma avaliação específica das políticas de segurança e privacidade aplicáveis aos dados corporativos.
A alternativa encontrada foi executar um modelo de linguagem localmente. Optei pelo Gemma 3 4B, utilizando o llama-server, componente do projeto llama.cpp que permite disponibilizar o modelo para consultas por meio de uma interface de servidor.
Essa abordagem permite realizar as inferências na própria máquina, reduzindo a necessidade de enviar o conteúdo da documentação para serviços externos. Entretanto, a viabilidade da execução depende dos recursos disponíveis no computador, especialmente da memória RAM e da capacidade de processamento.
Para tornar o recurso mais acessível, implementei a inteligência artificial como uma funcionalidade opcional. Também desenvolvi um mecanismo de monitoramento do consumo de memória, que alerta o usuário quando a utilização do modelo pode comprometer o funcionamento normal do computador.
Pensando especialmente em máquinas com hardware mais limitado, incluí duas opções de execução: manter o modelo carregado enquanto o sistema estiver aberto ou inicializá-lo somente quando necessário para realizar consultas com IA.
Na segunda modalidade, o modelo é carregado sob demanda e permanece ativo por até dez minutos após a última utilização, sendo então encerrado para liberar os recursos do computador. Embora essa abordagem introduza alguns segundos de espera na primeira consulta, ela ajuda a equilibrar o desempenho da ferramenta com as limitações de hardware de cada usuário.
Com isso, a proposta não é apenas adicionar inteligência artificial à documentação, mas utilizá-la como uma camada complementar de pesquisa, capaz de facilitar o acesso ao conhecimento interno sem ignorar as limitações de infraestrutura e os requisitos de privacidade.
Comentários
top
Deixar um comentário